Wissensquellen
Achtzehn Rückfragen aus einem Hochschulverbund
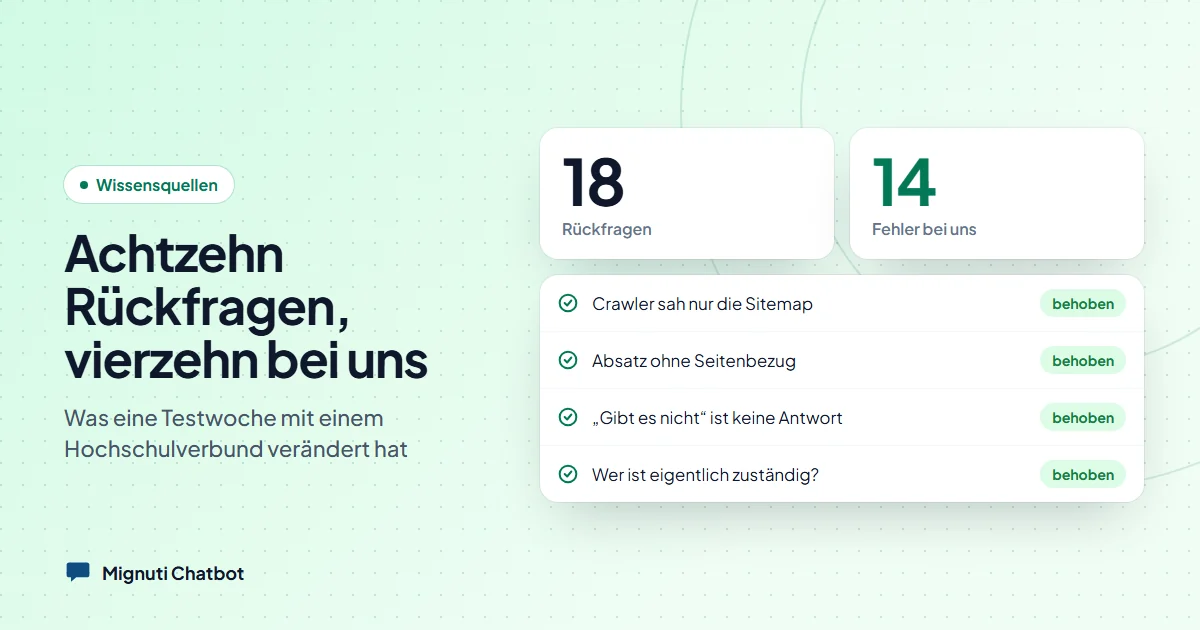
Ein Hochschulverbund hat unseren Chatbot eine Woche getestet und achtzehn Rückfragen geschickt. Vierzehn waren Fehler bei uns. Was wir daraus gebaut haben.
Inhalt
Vor zwei Wochen hat ein Hochschulverbund angefangen, unseren Chatbot in einem Testprojekt mit seiner kompletten Website zu füttern: rund tausend Seiten, über hundert Studiengänge an vielen Hochschulen, ein Studienfinder mit Filtern und Seitenzahlen. Öffentlich ist der Bot dort nicht, er läuft nur im Test-Chat. Getestet hat die zuständige Kollegin trotzdem so, wie Studieninteressierte fragen würden, nicht mit einem Testprotokoll. Herausgekommen sind achtzehn Rückfragen, verteilt auf drei Mails.
Vierzehn davon waren Fehler oder fehlende Funktionen bei uns. Das ist der ehrliche Teil dieses Textes. Der andere Teil ist, was wir in einer Woche daraus gebaut haben. Alles davon ist heute für jeden Kunden drin.
Der Crawler sah nur die Sitemap
Die erste Rückfrage war die härteste: „Der Chatbot nutzt die Infos aus dem Studienfinder nicht.” Stimmte. Unser Crawler hatte sich an der Sitemap orientiert, und in der standen 174 Seiten und 269 Pressemeldungen, aber keine einzige Studiengangsseite. Das Content-Management-System der Hochschule listet Studiengänge über eine eigene Erweiterung, die in keiner Sitemap auftaucht. Google merkt das nicht, Google folgt Links. Wir folgten keinen.
Seitdem folgt der Crawler Links, zusätzlich zur Sitemap. Zwei Wochen später kam die Fortsetzung: Ein Studiengang fehlte trotzdem. Der Studienfinder verteilt seine Trefferliste auf sieben Seiten, und Seite zwei bis sieben erreicht man nur über Adressen mit Parametern. Genau solche Adressen ließen wir bewusst aus, weil sie auf vielen Websites für Filterkombinationen stehen, die dieselbe Liste in hundert Varianten zeigen. Bei diesem Verbund hingen dreizehn Studiengänge ausschließlich daran. Jetzt unterscheidet der Crawler reine Seitenzahlen von Filtern: Seitenzahlen folgt er, sammelt die Links ein und speichert die Listenseite nicht als Inhalt.
Ein Absatz, der nicht weiß, zu welcher Seite er gehört
„Die Antworten zu den Kosten gefallen mir nicht.” Die Gebühren standen auf der Seite und auch in der Wissensbasis, wörtlich. Trotzdem sagte der Bot, er finde nichts. Der Grund war so simpel wie unsichtbar: Für die Suche werden Seiten in Abschnitte von rund 600 Zeichen zerlegt. Der Kosten-Abschnitt sagte „Die Modulgebühr beträgt 65 Euro”, aber nicht, für welchen Studiengang. Das stand nur in der Überschrift der Seite. Und über hundert Studiengangsseiten hatten einen fast wortgleichen Kosten-Abschnitt. Die Suche fand also die Einleitung des richtigen Studiengangs und den Kosten-Absatz eines falschen.
Seitdem trägt jeder Abschnitt den Titel seiner Seite als erste Zeile. Das klingt banal. Es ist die Änderung mit der größten Wirkung aus dieser Runde, und sie gilt inzwischen auch für hochgeladene Texte und PDFs.
„Gibt es nicht” ist keine Antwort
Als der eine Studiengang im Index fehlte, fragte die Kollegin den Bot direkt danach. Er antwortete: „Nein, dieser Studiengang wird an dieser Hochschule nicht angeboten.” Das war falsch, und schlimmer als ein „weiß ich nicht”: Es klang wie eine geprüfte Aussage. Nicht-Finden ist kein Beleg fürs Nicht-Existieren. Der Bot darf das seitdem nicht mehr behaupten, solange keine Quelle es ausdrücklich sagt.
Aus derselben Rückfrage entstand die Seitenliste, wie sie heute ist: jede gecrawlte Seite mit Status, Anzahl der Abschnitte und Fehlergrund. Und darüber ein Feld, in das du eine fehlende Adresse einträgst. Die Seite wird sofort geholt und bleibt angeheftet, auch wenn kein Link mehr dorthin führt.
Wer ist eigentlich zuständig?
Zwei Rückfragen drehten sich um Menschen. Erst nannte der Bot die Durchwahl einer Mitarbeiterin, die er auf irgendeiner Seite gefunden hatte, für Fragen, für die sie nicht zuständig war. Also bauten wir zentrale Kontaktdaten: Trägt der Kunde sie ein, nennt der Bot nur noch diese und zitiert keine Telefonnummer mehr aus den Seiten.
Dann kam die Gegenrichtung: Jede Studiengangsseite hat unten einen Block „Meine Ansprechpersonen”, und genau die sollen genannt werden, nicht die Zentrale. Daraus wurde ein Schalter. Ist er an, darf der Bot Personen samt Durchwahl nennen, die eine Seite ausdrücklich als Ansprechpersonen mit Rolle ausweist. Wer nur im Text vorkommt, etwa als Studiengangsleitung, wird nicht zum Kontakt.
Und die dritte Frage dieser Art: „Wie bringe ich dem Chatbot bei, dass wir keine Hochschule sind?” Der Verbund ist eine Landeseinrichtung, die Fernstudiengänge koordiniert. Auf die Frage nach der Anfahrt zu einem Campus empfahl der Bot, „die Hochschule” anzurufen, und gab die Nummer des Verbunds. Er wusste schlicht nicht, wen er vertritt. Sein Prompt nannte nur seinen eigenen Namen. Heute hat jeder Bot ein Feld „Über die Organisation”, und die Regel, nie zu raten, was für eine Organisation hinter ihm steht.
Die kleineren Dinge
- Ein gesperrtes Wort in der Bot-Konfiguration blockte 551 Abschnitte, ohne dass es jemand sah. Die Oberfläche zeigt jetzt bei jedem gesperrten Begriff, wie viele Abschnitte er treffen würde.
- Der Bot duzte und siezte denselben Besucher innerhalb eines Gesprächs. Die Anrede ist jetzt Teil der Anweisung und folgt der Ton-Einstellung.
- Die Antwortsprache hing an der Spracheinstellung des Widgets, nicht an der Sprache der Frage. Jetzt folgt sie der letzten Nachricht des Besuchers.
- Abkürzungen wie „MAPS” fand die Suche nicht, weil das Modell darin Landkarten sah. Es gibt jetzt ein Glossar, das vor der Suche greift.
- Links in Antworten waren eine Empfehlung an das Modell, keine Vorgabe, und niemand prüfte, ob ein Link überhaupt aus den Quellen stammt. Jetzt ist es eine Vorgabe, und jeder Link wird gegen die tatsächlich genutzten Quellen geprüft.
- Zwölf Studiengangsseiten brauchten fünf bis sieben Sekunden, bis der Server sie auslieferte. Unser Crawler wartete sechs. Jetzt wartet er zwölf.
Was wir daraus mitnehmen
Kein Testprotokoll hätte diese achtzehn Punkte gefunden. Sie kamen von jemandem, der die eigenen Inhalte kennt und Fragen stellt, auf die man von außen nicht kommt. Die zweite Lehre: Fast jeder Punkt wurde zu einer Regel oder einem Schalter, nicht zu einem Sonderfall für einen Kunden. Und die dritte: Ein Chatbot ist nur so gut wie die Sicht darauf, was er weiß. Deshalb steckt die meiste Arbeit dieser Woche nicht im Modell, sondern in der Seitenliste, den offenen Fragen und den Quellen unter jeder Antwort.
Wenn du selbst hunderte Seiten hinter einem Finder hast: Chatbot für Hochschulen & Weiterbildung.
Dein eigener Chatbot, aus deinen Inhalten
Trag deine Website ein, lade PDFs hoch oder verbinde einen Ordner. Der Bot beantwortet Fragen nur aus deinen Quellen. 7 Tage kostenlos testen.