KI & Antworten
KI-Chatbot lokal und ohne OpenAI betreiben
Dein KI-Chatbot darf nicht zu OpenAI oder Anthropic? Pro Projekt bindest du jetzt ein eigenes oder lokales Modell an. So geht es, und das haben wir gemessen.
Inhalt
Manche Organisationen dürfen ihre Texte nicht an einen US-Anbieter schicken. Punkt. Für sie war ein KI-Chatbot bisher schwierig, denn fast alle Anbieter hängen an OpenAI oder Anthropic. Seit Oktober 2026 kannst du in Mignuti Chatbot pro Projekt ein eigenes Sprachmodell anbinden. Damit läuft dein KI-Chatbot lokal auf deiner Hardware oder bei einem Anbieter deiner Wahl, ganz ohne OpenAI und ohne Anthropic.
Hier steht, wie das funktioniert, was wir auf einer handelsüblichen Grafikkarte gemessen haben und wo die ehrlichen Grenzen liegen.
Für wen das gedacht ist
Standardmäßig antwortet jeder Mignuti-Bot mit Claude Haiku von Anthropic, die Suche läuft über Embeddings von OpenAI. Beide sitzen in den USA, die Übermittlung ist über EU-Standardvertragsklauseln abgesichert. Für die meisten Unternehmen ist das in Ordnung. Wie das datenschutzrechtlich aussieht, haben wir in Was „DSGVO-konform“ bei KI-Chatbots wirklich heißt beschrieben.
Für manche reicht das nicht:
- Behörden und öffentliche Stellen mit Landes- oder Hausvorgaben
- Hochschulen und Forschungseinrichtungen, die ohnehin eigene Rechenzentren oder Zugang zu akademischen KI-Diensten haben
- Kliniken und Einrichtungen im Gesundheitswesen
- Unternehmen mit Konzernvorgaben, die externe KI-Anbieter nur nach Freigabe erlauben
Wenn du dazugehörst, ist das eigene Modell für dich gebaut. Wie ein Bot für die Studienberatung aussieht, zeigt die Seite Chatbot für Hochschulen.
So läuft dein KI-Chatbot ohne OpenAI
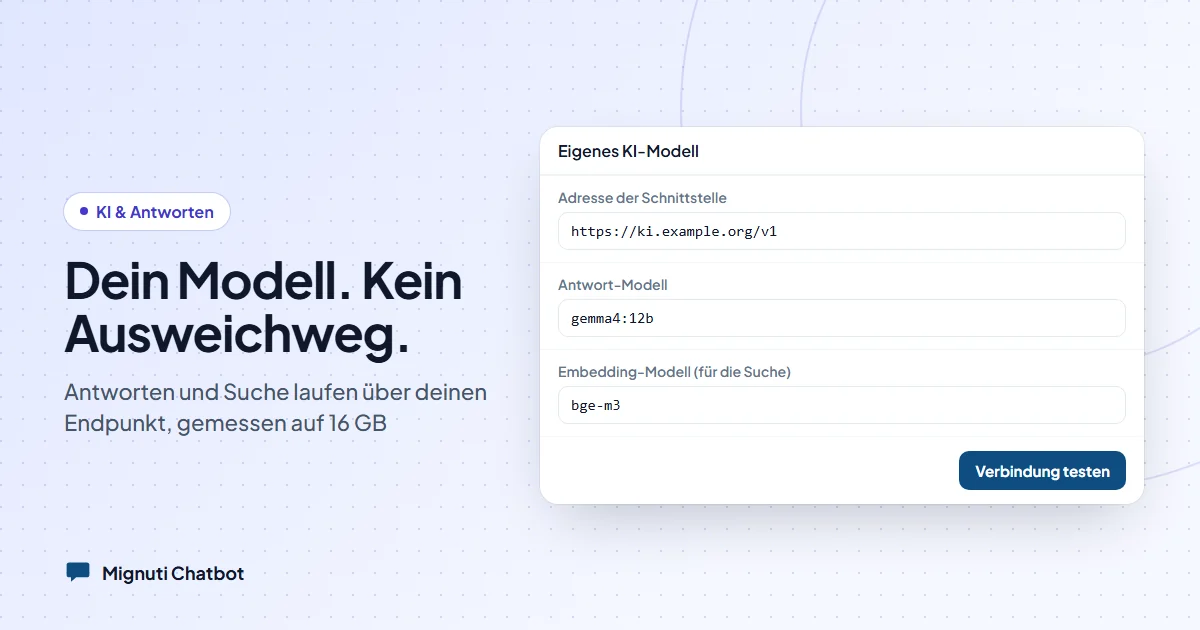
Im Bot-Studio unter „Verhalten“ findest du den Bereich „Eigenes KI-Modell“. Ihn sehen nur Projekt-Admins. Dort trägst du vier Dinge ein:
- Adresse der Schnittstelle, meist endet sie auf
/v1 - API-Schlüssel
- Antwort-Modell, also das Sprachmodell, das die Antworten formuliert
- Embedding-Modell für die Suche, zum Beispiel
bge-m3
Die Schnittstelle muss das OpenAI-Format sprechen. Das tun die gängigen Werkzeuge: Ollama oder vLLM auf eigener Grafikkarte, und auch gehostete Dienste wie die Academic Cloud der GWDG, STACKIT oder IONOS. Gemessen haben wir bisher mit Ollama auf eigener Hardware.
Ist der Endpunkt gesetzt, laufen alle KI-Aufrufe des Projekts darüber: die Antworten im Widget und im Test-Chat, die Prüfung, ob eine Antwort zu den Quellen passt, die Auswahl der Aktionsknöpfe, die Lead-Bewertung, die Themen-Auswertung, die Antwortvorschläge für offene Fragen und die Rechtschreibprüfung. Dazu die Embeddings für Website-Seiten, Texte, Frage-Antwort-Paare und hochgeladene Dateien.
Und das Wichtigste: Es gibt keinen Ausweichweg. Fällt dein Modell aus, fragt der Bot nicht heimlich Anthropic oder Azure. Er liefert dann lieber einen Fehler als einen stillen Datenabfluss.
Ein Detail, das du kennen solltest: Lässt du das Feld für das Embedding-Modell leer, bleibt die Suche beim Standard, also bei OpenAI. Wer gar keine Daten an OpenAI geben darf, trägt dort ein eigenes Modell ein.
Umstellen ohne neu zu crawlen
Ein neues Embedding-Modell rechnet Texte anders in Zahlen um. Die alten Vektoren passen dann nicht mehr. Wir crawlen deine Website deshalb nicht neu, sondern berechnen die gespeicherten Abschnitte mit dem neuen Modell neu. Das dauert einige Minuten. In dieser Zeit findet die Suche nur die schon umgerechneten Abschnitte, der Bot weiß also vorübergehend weniger. Plan die Umstellung am besten nicht mitten in die Hauptsaison.
Mit „Verbindung testen“ prüfst du vorher, ob Antwort- und Embedding-Modell erreichbar sind und wie schnell sie antworten.
Lokal ohne offenen Port
Viele Server stehen hinter einer Firewall, etwa ein NAS im Büro oder ein Rechner im Hochschulnetz. Dafür gibt es ein fertiges Paket: Ollama für die Modelle, davor ein Zugang, der nur die drei nötigen Schnittstellen und nur mit API-Schlüssel durchlässt, und optional ein verschlüsselter Rückkanal per SSH. Die Verbindung geht dabei von deinem Server nach außen. Am Router musst du nichts öffnen.
Voraussetzung laut Paket: eine NVIDIA-Grafikkarte mit mindestens 16 GB Speicher, rund 15 GB Platz für die Modelle und Docker mit NVIDIA-Unterstützung.
Was wir auf 16 GB gemessen haben
Wir haben das an einem echten Bot einer Bildungseinrichtung ausprobiert, auf einer Grafikkarte mit 16 GB Speicher (RTX 4060 Ti). 14 Fragen über den Test-Chat: 11 echte Fragen und 3 Fangfragen, auf die die Website keine Antwort hat. Bei den Fangfragen zeigt sich, ob ein Modell zugibt, dass es etwas nicht weiß, oder ob es etwas erfindet.
| Antwortmodell | Fangfragen ehrlich | Antwortzeit |
|---|---|---|
| Claude Haiku 5.5 (Standard) | 3 von 3 | 2–8 s |
| gemma4:12b | 3 von 3 | 6–11 s |
| ministral-3:14b | 3 von 3 | 8–35 s |
| qwen3:14b ohne Nachdenken | 2 von 3 | 4–24 s |
| gemma3:12b | 1 von 3 | 7–17 s |
| qwen3.5:9b | 1 von 3 | 5–17 s |
Was wir daraus mitnehmen:
- Ein Modell hat auf 16 GB überzeugt.
gemma4:12bhat alle drei Fangfragen ehrlich beantwortet und alle 11 echten Fragen beantwortet. Bei einer Frage nach einer Frist, die auf der Website nicht stand, sagte es genau das, nannte die anderen Fristen ausdrücklich als andere und verwies auf den direkten Kontakt. - Die anderen haben erfunden. Mehrere Modelle nannten eine Frist, die es nicht gibt, oder vermuteten eine Antwort statt zu sagen, dass sie fehlt. Genau das ist bei einem Website-Bot das größte Risiko.
- „Nachdenken“ kostet Zeit. Modelle mit eingebautem Nachdenkschritt waren teils sehr langsam oder lieferten leere Antworten, weil das Nachdenken das Budget aufbrauchte. Bei eigenen Endpunkten schicken wir deshalb automatisch mit, dass das Nachdenken aus sein soll. Bei einer kurzen Frage waren das 0,6 statt 11 Sekunden.
- Als Prüfer taugt ein kleines Modell nicht. Wir haben lokale Modelle auch als Antwortprüfer getestet. Auf 16 GB erkannten sie Erfindungen kaum und verwarfen dafür korrekte Antworten.
Die ehrlichen Grenzen
Qualität. Claude Haiku war in unserem Test schneller und von sich aus ehrlich. Ein Modell mit 12 bis 14 Milliarden Parametern erreicht das nur in Einzelfällen. Für „nichts erfinden“ auf diesem Niveau ist der nächste Schritt ein größeres Modell, also eine Grafikkarte mit 24 GB oder mehr oder ein gehosteter Dienst mit großen Modellen.
Gleichzeitige Besucher. Eine 16-GB-Karte beantwortet eine Anfrage nach der anderen. Für mehrere gleichzeitige Nutzer braucht es mehr Grafikspeicher.
Betrieb. Das Modell läuft bei dir. Hardware, Updates und Verfügbarkeit liegen damit auch bei dir. Und weil es keinen Ausweichweg gibt, beantwortet dein Bot keine Fragen, solange dein Server aus ist.
Was trotzdem bleibt. Das eigene Modell ersetzt die KI-Dienste. Die Plattform selbst, also Datenbank, Wissen und Gespräche, läuft weiter auf unserem Server bei netcup in Deutschland. E-Mails gehen über Resend, die Abrechnung über Stripe, die Oberfläche und die Widget-Datei werden über Cloudflare ausgeliefert. Der Chat selbst geht direkt an unseren Server. Wenn deine Vorgabe „alles im eigenen Haus“ lautet, klären wir das gemeinsam.
Was es kostet und wie du startest
Ob und wie sich das eigene Modell auf deinen Tarif auswirkt und ob du einen Rückkanal brauchst, besprechen wir am besten direkt: Sprich uns an. Den Rückkanal richten wir für dich ein, und bei der Modellwahl hilft dir das, was wir oben gemessen haben.
Unser Rat aus den Messungen: Stell dem Bot vor dem Start ein paar Fragen, auf die deine Website keine Antwort hat. Wie er darauf reagiert, sagt mehr über dein Modell als jede Benchmark. Wie wir das beim Wechsel auf Claude Haiku 5.5 gemacht haben, steht in Neues KI-Modell: Claude Haiku 5.5 für alle Bots. Mehr zu Hosting und Datenflüssen findest du auf der Seite Sicherheit und Vertrauen.
Dein eigener Chatbot, aus deinen Inhalten
Trag deine Website ein, lade PDFs hoch oder verbinde einen Ordner. Der Bot beantwortet Fragen nur aus deinen Quellen. 7 Tage kostenlos testen.